O que cada sintoma significa
Todo arquivo guarda as letras como números. A codificação de caracteres é a tabela que diz qual número corresponde a cada letra. As letras inglesas simples têm os mesmos números em quase todas as tabelas, por isso legendas em inglês raramente quebram. Letras acentuadas, cirílico, grego, árabe, hebraico, chinês e japonês não têm essa sorte.
| O que você vê | Deveria ser | O que aconteceu |
|---|---|---|
café |
café | Um arquivo UTF-8 foi lido como Windows-1252 (Europa Ocidental) |
Γειά σου |
Γειά σου | Um arquivo UTF-8 foi lido como Windows-1252 |
Ïðèâåò |
Привет | Um arquivo Windows-1251 (cirílico) foi lido como Windows-1252 |
caf� |
café | Um arquivo Windows-1252 foi lido como UTF-8 |
caf? ou ??????? |
café | O texto foi salvo por um programa que não conseguia guardar as letras; elas se perderam |
Duas letras no lugar de cada letra acentuada (é, è) quase sempre indicam um arquivo UTF-8 lido da forma antiga. Um losango preto com um ponto de interrogação (�) costuma indicar o contrário: uma codificação antiga lida como UTF-8.
Confira o arquivo original antes de converter. Se as letras erradas ou os caracteres de substituição já foram gravados no texto, mudar a codificação não os recupera. Use uma cópia intacta; o texto já salvo com erro, como é, exige um reparo de texto à parte.
Corrija o arquivo: salve em UTF-8
- Abra Corrigir codificação de legendas e adicione os arquivos de legenda.
- A ferramenta deduz a codificação a partir do texto e mostra o grau de confiança, com as primeiras 20 linhas.
- Leia essas linhas. Se as letras parecerem erradas, escolha outra Codificação de caracteres; a pré-visualização é atualizada na hora.
- Baixe o arquivo. Ele é salvo em UTF-8 com as mesmas linhas, tempos e quebras de linha.
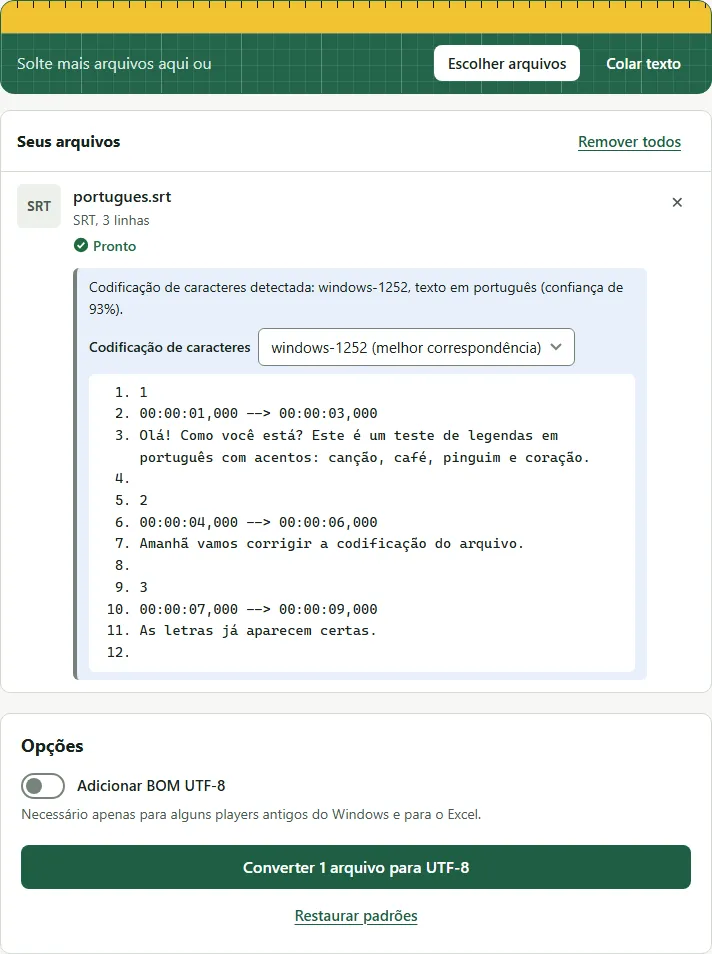
Por exemplo, esta frase em português salva como Windows-1252 é detectada e gravada em UTF-8 sem alterar nenhuma letra:
1
00:00:01,000 --> 00:00:03,000
Olá! Como você está? Este é um teste de legendas em português com acentos: canção, café, pinguim e coração.
1
00:00:01,000 --> 00:00:03,000
Olá! Como você está? Este é um teste de legendas em português com acentos: canção, café, pinguim e coração.
Por que a dedução pode errar
A ferramenta só enxerga os bytes. Um arquivo longo com muitas letras acentuadas é fácil de detectar. Um arquivo curto com uma ou duas palavras acentuadas pode pertencer a várias codificações, então a página avisa quando não tem certeza e pede que você confira a pré-visualização. Idiomas que compartilham letras, como os da Europa Central, são os mais propensos a exigir uma escolha manual.
Erros comuns
- Converter um arquivo duas vezes. Se o arquivo já está em UTF-8 e você força uma codificação antiga, você mesmo cria o problema do é. Mantenha o valor detectado, a menos que a pré-visualização pareça errada.
- Salvar de novo em um editor antigo. Alguns editores de texto salvam, por padrão, na codificação do sistema. Salve como UTF-8 ou baixe o arquivo de novo da ferramenta.
- Culpar a fonte. Se a pré-visualização mostra as letras certas, mas a TV mostra quadrados, a fonte da TV pode não ter essas letras. Isso é um problema do player, não da codificação.
Depois que as letras estiverem certas, você pode remover as anotações para surdos e ensurdecidos (SDH) ou converter o arquivo para outro formato.
Perguntas
Qual é a melhor codificação para legendas?
UTF-8. Ela armazena todos os idiomas, e players atuais, TVs, o YouTube e editores de vídeo a leem. Arquivos antigos costumavam ser salvos em uma codificação regional, como Windows-1252 ou Windows-1251.
Posso corrigir os caracteres mudando uma configuração do player?
Às vezes. Alguns players permitem escolher a codificação das legendas, mas a configuração só ajuda naquele aparelho e naquele tipo de arquivo. Converter o arquivo original para UTF-8 ajuda os players que o aceitam; se faltam caracteres na fonte, é preciso trocar de player ou de fonte.
No próprio arquivo as letras são pontos de interrogação. Dá para recuperá-las?
Não. Se o arquivo contém pontos de interrogação de verdade, as letras originais se perderam quando ele foi salvo. Procure outra cópia das legendas.
O que é BOM e preciso dele?
A marca de ordem de bytes (BOM) é um marcador invisível no início do arquivo que indica UTF-8. A maioria dos players não precisa dela. Ative-a somente se um programa antigo do Windows ainda mostrar letras quebradas.