Qué significa cada síntoma
Todos los archivos guardan las letras como números. La codificación de caracteres es la tabla que indica qué letra corresponde a cada número. Las letras inglesas sin acentos tienen los mismos números en casi todas las tablas, por eso los subtítulos en inglés rara vez presentan este problema. No ocurre lo mismo con las letras acentuadas ni con el cirílico, el griego, el árabe, el hebreo, el chino o el japonés.
| Lo que ves | Debería ser | Qué ocurrió |
|---|---|---|
café |
café | Un archivo UTF-8 se leyó como Windows-1252 (Europa occidental) |
Γειά σου |
Γειά σου | Un archivo UTF-8 se leyó como Windows-1252 |
Ïðèâåò |
Привет | Un archivo Windows-1251 (cirílico) se leyó como Windows-1252 |
caf� |
café | Un archivo Windows-1252 se leyó como UTF-8 |
caf? o ??????? |
café | Un programa que no podía almacenar esas letras guardó el texto; las letras se perdieron |
Ver dos caracteres por cada letra acentuada (é, è) casi siempre significa que se leyó UTF-8 con una codificación antigua. Un rombo negro con un signo de interrogación (�) suele indicar lo contrario: una codificación antigua leída como UTF-8.
Comprueba el archivo original antes de convertirlo. Si las letras incorrectas o los caracteres de sustitución ya quedaron guardados en el texto, cambiar la codificación no los restaura. Usa una copia sin daños; el texto mal decodificado que ya se guardó, como é, requiere una reparación de texto aparte.
Corregir el archivo: guardarlo como UTF-8
- Abre Corregir la codificación de subtítulos y añade los archivos de subtítulos.
- La herramienta intenta detectar la codificación a partir del texto y muestra su grado de confianza junto con las primeras 20 líneas.
- Lee esas líneas. Si las letras se ven mal, elige otra Codificación de caracteres; la vista previa se actualiza al momento.
- Descarga el archivo. Se guarda como UTF-8 con los mismos subtítulos, tiempos y saltos de línea.
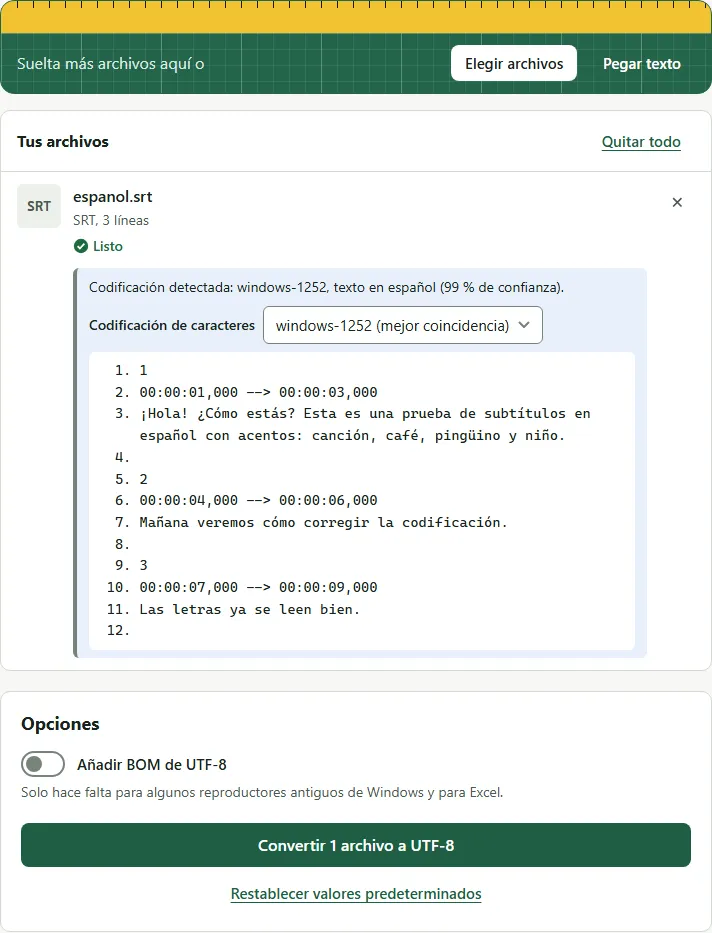
Por ejemplo, esta frase en español guardada como Windows-1252 se detecta y se guarda como UTF-8 sin cambiar ninguna letra:
1
00:00:01,000 --> 00:00:03,000
¡Hola! ¿Cómo estás? Esta es una prueba de subtítulos en español con acentos: canción, café, pingüino y niño.
1
00:00:01,000 --> 00:00:03,000
¡Hola! ¿Cómo estás? Esta es una prueba de subtítulos en español con acentos: canción, café, pingüino y niño.
Por qué puede fallar la detección
La herramienta solo puede examinar los bytes. Un archivo largo con muchas letras acentuadas resulta fácil de detectar. Uno corto con una o dos palabras acentuadas podría corresponder a varias codificaciones; por eso la página avisa cuando hay dudas y pide comprobar la vista previa. Los idiomas que comparten letras, como los de Europa central, son los que más pueden necesitar una selección manual.
Errores habituales
- Convertir un archivo dos veces. Si el archivo ya está en UTF-8 y fuerzas una codificación antigua, creas tú mismo el problema de é. Mantén el valor detectado salvo que la vista previa se vea mal.
- Volver a guardar en un editor antiguo. Algunos editores de texto guardan con la codificación del sistema de forma predeterminada. Guarda como UTF-8 o descarga otra vez desde la herramienta.
- Culpar a la fuente. Si la vista previa muestra las letras correctas pero el televisor muestra cuadrados, puede que su fuente no incluya esas letras. Es un problema del reproductor, no de la codificación.
Cuando las letras se vean bien, puedes quitar las notas para personas sordas o convertir el archivo a otro formato.
Preguntas
¿Qué codificación conviene usar para los subtítulos?
UTF-8. Puede almacenar todos los idiomas y es compatible con reproductores actuales, televisores, YouTube y editores de video. Los archivos antiguos solían guardarse con una codificación regional como Windows-1252 o Windows-1251.
¿Puedo corregir los caracteres cambiando un ajuste del reproductor?
A veces. Algunos reproductores permiten elegir la codificación de los subtítulos, pero el ajuste solo ayuda en ese dispositivo y para ese tipo de archivo. Convertir el archivo original a UTF-8 ayuda en los reproductores compatibles; si faltan caracteres en la fuente, hay que cambiar de reproductor o de fuente.
El propio archivo contiene signos de interrogación. ¿Se pueden recuperar las letras?
No. Si el archivo contiene signos de interrogación reales, las letras originales se perdieron al guardarlo. Busca otra copia de los subtítulos.
¿Qué es un BOM y lo necesito?
La marca de orden de bytes o BOM es una marca invisible al principio del archivo que indica que está en UTF-8. La mayoría de los reproductores no la necesitan. Actívala solo si un programa antiguo de Windows sigue mostrando letras incorrectas.