这些症状意味着什么
文件把每个文字都存成数字。字符编码是一张对照表,规定哪个数字对应哪个文字。基本的英文字母在几乎所有编码表中的数字都相同,所以英文字幕很少出问题。带重音的字母、西里尔字母、希腊字母、阿拉伯文、希伯来文,以及中文和日文则不然。
| 你看到的内容 | 本应显示 | 发生了什么 |
|---|---|---|
café |
café | UTF-8 文件被按 Windows-1252(西欧语言)读取 |
Γειά σου |
Γειά σου | UTF-8 文件被按 Windows-1252 读取 |
Ïðèâåò |
Привет | Windows-1251(西里尔字母)文件被按 Windows-1252 读取 |
caf� |
café | Windows-1252 文件被按 UTF-8 读取 |
caf? 或 ??????? |
café | 保存文本的程序无法存储这些文字,原来的文字已经丢失 |
每个带重音的字母变成两个字符(é、è),几乎都说明 UTF-8 文件被按旧方式读取。带问号的黑色菱形(�)通常相反:旧编码的文件被按 UTF-8 读取。
转换前请先检查原始文件。如果错误的字符或替换字符已经保存在文本里,更改字符编码也无法恢复。请使用没有损坏的副本;像 é 这样已经保存下来的乱码,需要另行修复文字。
修复文件:保存为 UTF-8
- 打开修复字幕编码,添加字幕文件。
- 工具会根据文字推测字符编码,并显示置信度和前 20 行。
- 阅读这些行。如果文字看起来不对,请选择另一种 字符编码 ,预览会立即更新。
- 下载文件。文件会保存为 UTF-8,行、时间和换行都保持不变。
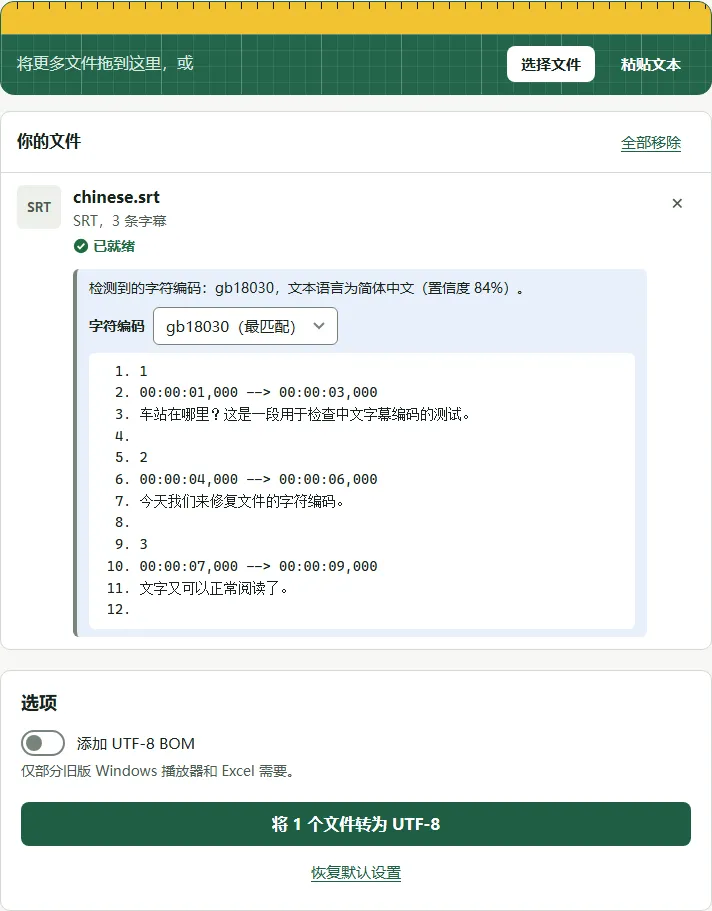
例如,下面这行以 gb18030 保存的中文会被检测出来,并保存为 UTF-8,一个字也不会改变:
1
00:00:01,000 --> 00:00:03,000
车站在哪里?这是一段用于检查中文字幕编码的测试。
1
00:00:01,000 --> 00:00:03,000
车站在哪里?这是一段用于检查中文字幕编码的测试。
为什么推测可能出错
工具只能查看字节。带重音字母很多的长文件很容易检测。只有一两个带重音单词的短文件,则可能符合多种字符编码,所以不确定时,页面会提示你,并请你检查预览。共用字母的语言,例如中欧语言,最可能需要手动选择。
常见错误
- 重复转换同一个文件。 如果文件已经是 UTF-8,你却强行指定旧字符编码,就会自己制造出 é 这样的问题。除非预览显示不对,否则请保留检测出的值。
- 用旧编辑器重新保存。 有些文本编辑器默认按系统字符编码保存。请另存为 UTF-8,或重新用工具下载。
- 怪罪字体。 如果预览里的文字正确,电视上却显示方框,可能是电视的字体里没有这些字符。这是播放器的问题,不是字符编码的问题。
文字显示正确后,你可以删除听障字幕说明,或将文件转换为其他格式。
常见问题
字幕最适合使用哪种编码?
UTF-8。它可以存储所有语言的文字,新版播放器、电视、YouTube 和视频剪辑软件都能读取。较旧的文件常以地区性字符编码保存,例如 Windows-1252 或 Windows-1251。
修改播放器设置能解决乱码吗?
有时可以。部分播放器允许选择字幕编码,但该设置只对那台设备和那一类文件有效。把原始文件转换为 UTF-8,对支持 UTF-8 的播放器有帮助;如果是字体缺少某些字符,则需要更换播放器或字体。
文件里的文字本身就是问号,还能恢复吗?
不能。如果文件里是真正的问号,说明原来的文字在保存时已经丢失。请另找一份字幕。
BOM 是什么?需要添加吗?
字节顺序标记(BOM)是写在文件开头的不可见标记,用来表明文件是 UTF-8。多数播放器不需要它。只有旧版 Windows 程序仍显示乱码时,才需要开启。