Arti gejala yang terlihat
Setiap file menyimpan huruf sebagai angka. Set karakter (encoding) adalah tabel yang menentukan huruf untuk setiap angka. Huruf bahasa Inggris tanpa aksen memiliki angka yang sama di hampir semua tabel, sehingga subtitle bahasa Inggris jarang bermasalah. Hal ini tidak berlaku untuk huruf beraksen, Kiril, Yunani, Arab, Ibrani, Mandarin, dan Jepang.
| Yang terlihat | Seharusnya | Penyebab |
|---|---|---|
café |
café | File UTF-8 dibaca sebagai Windows-1252 (Eropa Barat) |
Γειά σου |
Γειά σου | File UTF-8 dibaca sebagai Windows-1252 |
Ïðèâåò |
Привет | File Windows-1251 (Kiril) dibaca sebagai Windows-1252 |
caf� |
café | File Windows-1252 dibaca sebagai UTF-8 |
caf? atau ??????? |
café | Teks disimpan oleh program yang tidak dapat menyimpan huruf tersebut; huruf aslinya sudah hilang |
Dua karakter untuk setiap huruf beraksen (é, è) hampir selalu berarti UTF-8 dibaca dengan encoding lama. Simbol belah ketupat hitam bertanda tanya (�) biasanya berarti sebaliknya: set karakter lama dibaca sebagai UTF-8.
Periksa file asli sebelum mengonversinya. Jika huruf yang salah atau karakter pengganti sudah tersimpan dalam teks, mengganti set karakter tidak dapat memulihkannya. Gunakan salinan yang tidak rusak; teks salah baca yang sudah tersimpan, seperti é, memerlukan perbaikan teks tersendiri.
Perbaiki file: simpan sebagai UTF-8
- Buka Perbaiki encoding subtitle dan tambahkan file subtitle.
- Alat menebak set karakter dari teks, menampilkan tingkat keyakinannya, dan memperlihatkan 20 baris pertama.
- Baca baris tersebut. Jika hurufnya salah, pilih Set karakter lain; pratinjau langsung diperbarui.
- Unduh file. File disimpan sebagai UTF-8 dengan baris, waktu, dan pemisah baris yang sama.
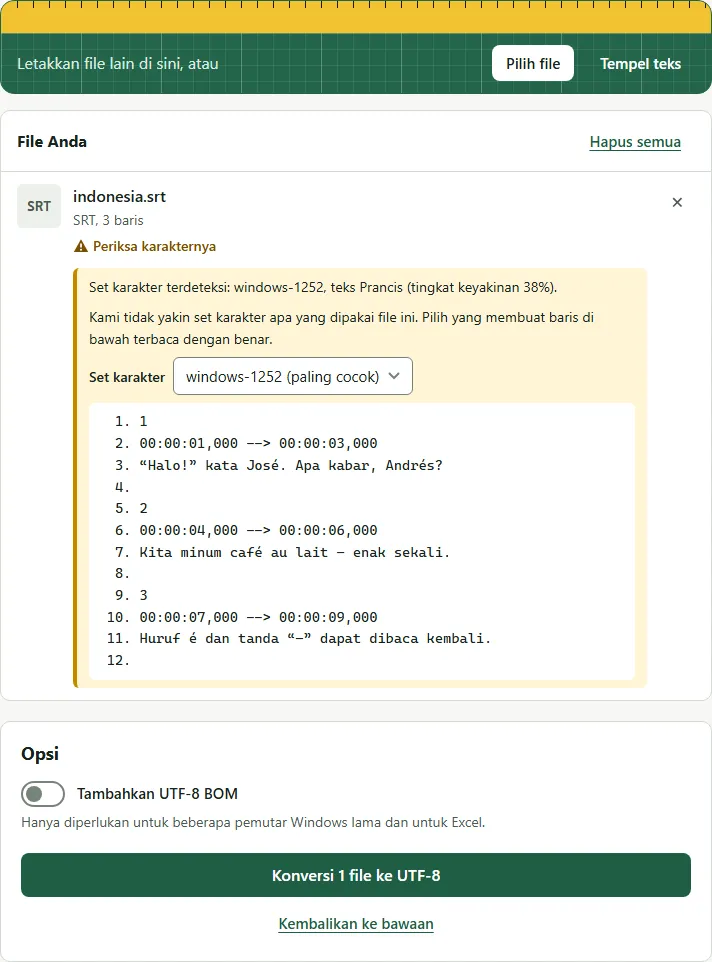
Teks bahasa Indonesia tanpa aksen sama di hampir semua set karakter, jadi kerusakan biasanya muncul pada tanda kutip lengkung, tanda pisah, dan nama asing. Sebagai contoh, baris berikut yang disimpan sebagai Windows-1252 dapat disimpan kembali sebagai UTF-8 tanpa mengubah satu huruf pun. Karena file contoh ini pendek, halaman menandai tebakannya sebagai tidak pasti dan meminta Anda memeriksa pratinjau:
1
00:00:01,000 --> 00:00:03,000
“Halo!” kata José. Apa kabar, Andrés?
1
00:00:01,000 --> 00:00:03,000
“Halo!” kata José. Apa kabar, Andrés?
Mengapa tebakan bisa keliru
Alat hanya dapat memeriksa byte. File panjang dengan banyak huruf beraksen lebih mudah dikenali. File pendek dengan satu atau dua kata beraksen bisa cocok dengan beberapa set karakter, sehingga halaman memberi tahu saat hasilnya tidak pasti dan meminta Anda memeriksa pratinjau. Bahasa yang memakai huruf serupa, seperti bahasa-bahasa Eropa Tengah, lebih mungkin memerlukan pilihan manual.
Kesalahan umum
- Mengonversi file dua kali. Jika file sudah UTF-8 lalu Anda memaksakan set karakter lama, Anda justru membuat masalah é. Biarkan nilai terdeteksi kecuali pratinjau terlihat salah.
- Menyimpan ulang di editor lama. Beberapa editor teks memakai set karakter sistem secara bawaan. Simpan sebagai UTF-8, atau unduh ulang dari alat.
- Menganggap font sebagai penyebab. Jika pratinjau menampilkan huruf yang benar tetapi TV menampilkan kotak, font TV mungkin tidak memiliki huruf tersebut. Masalahnya ada pada pemutar, bukan encoding.
Setelah hurufnya benar, Anda dapat menghapus keterangan untuk tunarungu atau mengonversi file ke format lain.
Pertanyaan
Encoding apa yang sebaiknya digunakan untuk subtitle?
UTF-8. Encoding ini dapat menyimpan semua bahasa dan dibaca oleh pemutar modern, TV, YouTube, serta editor video. File lama sering disimpan dalam set karakter regional seperti Windows-1252 atau Windows-1251.
Bisakah karakter diperbaiki melalui pengaturan pemutar?
Kadang bisa. Beberapa pemutar menyediakan pilihan encoding subtitle, tetapi pengaturan itu hanya membantu pada perangkat tersebut dan untuk jenis file itu. Mengonversi file asli ke UTF-8 membantu pemutar yang mendukungnya; karakter yang tidak tersedia pada font memerlukan penggantian pemutar atau font.
Huruf dalam file sudah menjadi tanda tanya. Bisakah dipulihkan?
Tidak. Jika file berisi tanda tanya sungguhan, huruf aslinya sudah hilang saat file disimpan. Cari salinan subtitle lain.
Apa itu BOM dan apakah diperlukan?
Byte order mark adalah penanda tak terlihat di awal file yang menunjukkan bahwa encoding-nya UTF-8. Kebanyakan pemutar tidak memerlukannya. Aktifkan hanya jika program Windows lama masih menampilkan karakter rusak.