Các dấu hiệu nghĩa là gì
Mỗi tệp lưu chữ dưới dạng các con số. Bảng mã ký tự (encoding) là bảng cho biết số nào ứng với chữ nào. Chữ cái tiếng Anh không dấu có cùng số ở hầu hết các bảng, nên phụ đề tiếng Anh ít khi lỗi. Chữ có dấu (kể cả tiếng Việt), chữ Cyrillic, Hy Lạp, Ả Rập, Do Thái, Trung và Nhật thì không.
| Bạn thấy | Đúng ra là | Chuyện gì đã xảy ra |
|---|---|---|
café |
café | Tệp UTF-8 bị đọc như Windows-1252 (Tây Âu) |
Tiếng Việt |
Tiếng Việt | Tệp UTF-8 bị đọc như Windows-1252 |
Γειά σου |
Γειά σου | Tệp UTF-8 bị đọc như Windows-1252 |
Ïðèâåò |
Привет | Tệp Windows-1251 (Cyrillic) bị đọc như Windows-1252 |
caf� |
café | Tệp Windows-1252 bị đọc như UTF-8 |
caf? hoặc ??????? |
café | Chương trình lưu tệp không lưu được các chữ này; chữ đã mất |
Mỗi chữ có dấu thành hai ký tự (é, è) hầu như luôn có nghĩa là tệp UTF-8 bị đọc theo cách cũ. Hình thoi đen có dấu hỏi (�) thường là trường hợp ngược lại: tệp dùng bảng mã cũ bị đọc như UTF-8.
Hãy kiểm tra tệp gốc trước khi chuyển. Nếu chữ sai hoặc ký tự thay thế đã được lưu vào nội dung, đổi bảng mã không khôi phục được. Hãy dùng một bản chưa hỏng; chữ lỗi đã lưu, như é, cần được sửa riêng.
Sửa tệp: lưu thành UTF-8
- Mở Sửa lỗi bảng mã phụ đề và thêm các tệp phụ đề.
- Công cụ đoán bảng mã từ chữ trong tệp, cho biết mức tin cậy và hiển thị 20 dòng đầu.
- Đọc các dòng đó. Nếu chữ trông sai, chọn Bảng mã ký tự khác; phần xem trước cập nhật ngay.
- Tải tệp về. Tệp được lưu thành UTF-8, giữ nguyên các dòng, giờ và chỗ ngắt dòng.
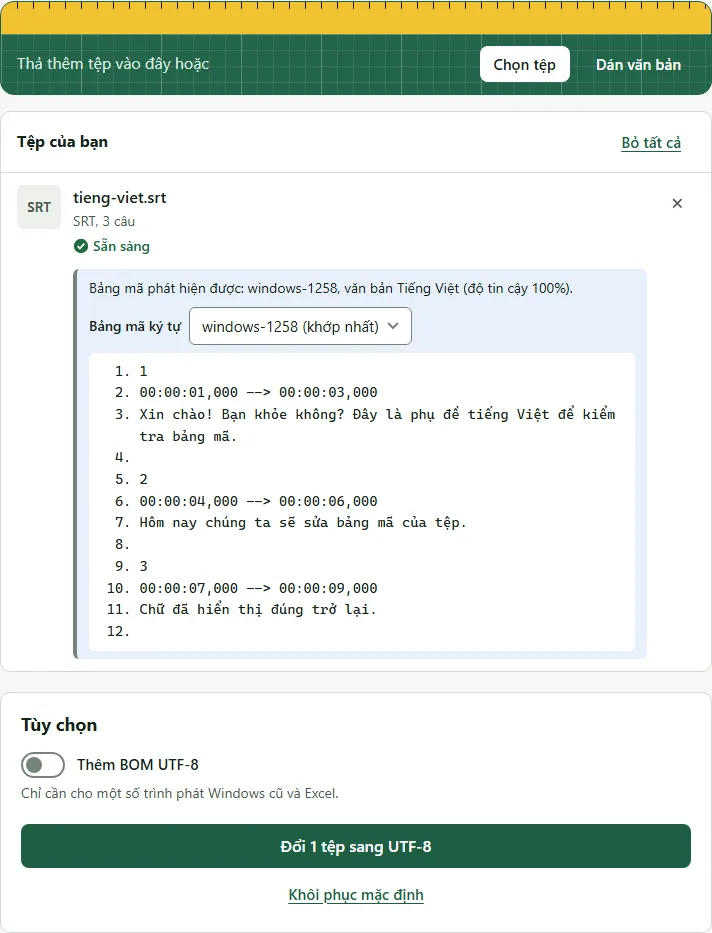
Ví dụ, dòng tiếng Việt này được lưu bằng Windows-1258 sẽ được nhận diện và lưu thành UTF-8 mà không đổi một chữ nào:
1
00:00:01,000 --> 00:00:03,000
Tôi đi Hà Đông, anh có đi không?
1
00:00:01,000 --> 00:00:03,000
Tôi đi Hà Đông, anh có đi không?
Vì sao việc đoán có thể sai
Công cụ chỉ nhìn được các byte. Tệp dài có nhiều chữ có dấu thì dễ nhận diện. Tệp ngắn chỉ có một hai từ có dấu có thể thuộc về nhiều bảng mã, nên trang cho biết khi chưa chắc và nhờ bạn kiểm tra phần xem trước. Những ngôn ngữ dùng chung chữ cái, như các ngôn ngữ Trung Âu, là nhóm dễ cần chọn tay nhất.
Những lỗi thường gặp
- Chuyển bảng mã hai lần. Nếu tệp đã là UTF-8 mà bạn ép dùng bảng mã cũ, chính bạn tạo ra lỗi é. Cứ để giá trị công cụ phát hiện, trừ khi phần xem trước trông sai.
- Lưu lại bằng trình soạn thảo cũ. Một số trình soạn thảo mặc định lưu theo bảng mã của hệ thống. Hãy lưu dạng UTF-8, hoặc tải lại từ công cụ.
- Đổ lỗi cho phông chữ. Nếu phần xem trước hiện đúng chữ mà TV hiện ô vuông, phông chữ của TV có thể thiếu các chữ đó. Đó là lỗi của trình phát, không phải của bảng mã.
Sau khi chữ đã đúng, bạn có thể làm sạch chú thích cho người khiếm thính hoặc đổi tệp sang định dạng khác.
Câu hỏi thường gặp
Nên lưu phụ đề bằng bảng mã nào?
UTF-8. Nó lưu được mọi ngôn ngữ, và các trình phát, TV, YouTube cùng phần mềm dựng video hiện nay đều đọc được. Tệp cũ thường được lưu bằng bảng mã theo khu vực như Windows-1252 hoặc Windows-1251.
Đổi cài đặt trình phát có sửa được ký tự lạ không?
Đôi khi được. Một số trình phát cho chọn bảng mã phụ đề, nhưng cài đặt đó chỉ có tác dụng trên thiết bị ấy và với một loại tệp. Chuyển tệp gốc sang UTF-8 giúp những trình phát hỗ trợ UTF-8; nếu phông chữ thiếu ký tự thì cần đổi trình phát hoặc phông chữ.
Chính trong tệp, chữ đã thành dấu hỏi. Khôi phục được không?
Không. Nếu tệp chứa dấu hỏi thật, chữ gốc đã mất khi lưu. Hãy tìm một bản phụ đề khác.
BOM là gì và tôi có cần không?
Dấu thứ tự byte (BOM) là một dấu ẩn ở đầu tệp, cho biết tệp là UTF-8. Phần lớn trình phát không cần. Chỉ bật khi một chương trình Windows cũ vẫn hiện sai chữ.