Was die Symptome bedeuten
Jede Datei speichert Buchstaben als Zahlen. Ein Zeichensatz (Kodierung) ist die Tabelle, die festlegt, welche Zahl für welchen Buchstaben steht. Einfache englische Buchstaben haben in fast allen Tabellen dieselben Zahlen, deshalb gehen englische Untertitel selten kaputt. Bei Umlauten und anderen Akzentbuchstaben, Kyrillisch, Griechisch, Arabisch, Hebräisch, Chinesisch und Japanisch ist das anders.
| Sie sehen | Richtig wäre | Was passiert ist |
|---|---|---|
café |
café | Eine UTF-8-Datei wurde als Windows-1252 (Westeuropäisch) gelesen |
Γειά σου |
Γειά σου | Eine UTF-8-Datei wurde als Windows-1252 gelesen |
Ïðèâåò |
Привет | Eine Windows-1251-Datei (Kyrillisch) wurde als Windows-1252 gelesen |
caf� |
café | Eine Windows-1252-Datei wurde als UTF-8 gelesen |
caf? oder ??????? |
café | Ein Programm, das die Buchstaben nicht speichern konnte, hat den Text gespeichert; sie sind verloren |
Zwei Zeichen für jeden Umlaut (ö, ü) bedeuten fast immer, dass UTF-8 auf die alte Weise gelesen wurde. Eine schwarze Raute mit Fragezeichen (�) deutet meist auf das Gegenteil hin: Ein alter Zeichensatz wurde als UTF-8 gelesen.
Prüfen Sie die Originaldatei, bevor Sie konvertieren. Wurden die falschen Buchstaben oder Ersatzzeichen bereits in den Text gespeichert, stellt ein Wechsel des Zeichensatzes sie nicht wieder her. Verwenden Sie eine unbeschädigte Kopie; schon gespeicherte Zeichenfehler wie ö brauchen eine gesonderte Textreparatur.
Datei reparieren: als UTF-8 speichern
- Öffnen Sie Untertitel-Kodierung reparieren und fügen Sie die Untertiteldateien hinzu.
- Das Werkzeug schätzt den Zeichensatz anhand des Textes und zeigt die Sicherheit der Erkennung mit den ersten 20 Zeilen.
- Lesen Sie diese Zeilen. Sehen die Buchstaben falsch aus, wählen Sie einen anderen Zeichensatz; die Vorschau wird sofort aktualisiert.
- Laden Sie die Datei herunter. Sie wird als UTF-8 gespeichert, mit denselben Zeilen, Zeiten und Zeilenumbrüchen.
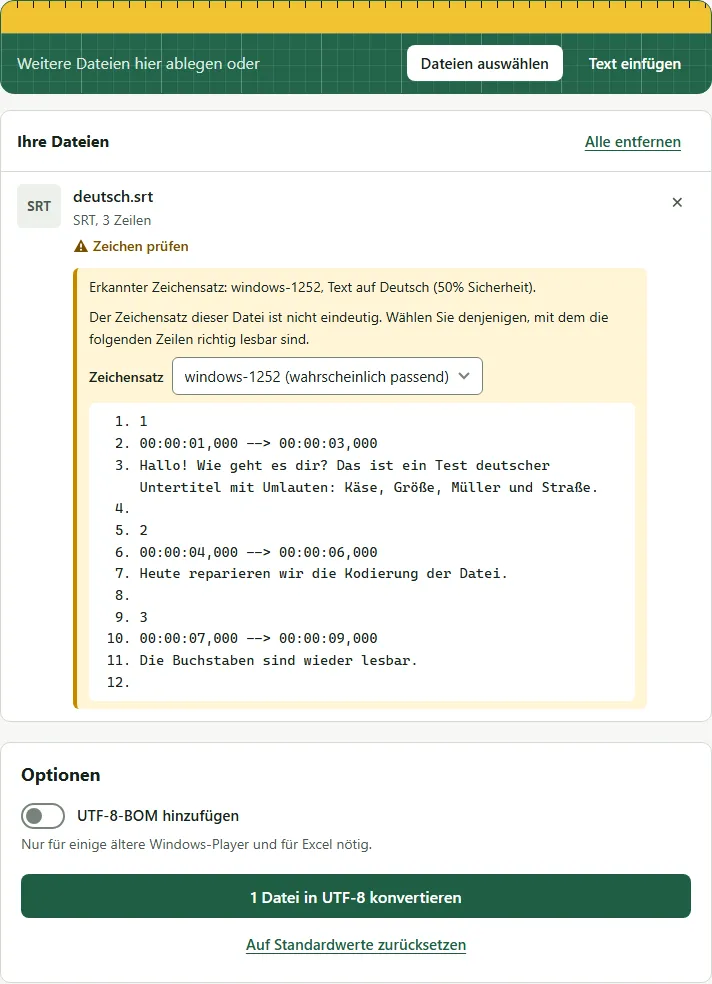
Diese deutsche Zeile, als Windows-1252 gespeichert, wird zum Beispiel erkannt und ohne Änderung eines einzigen Buchstabens als UTF-8 gespeichert:
1
00:00:01,000 --> 00:00:03,000
Hallo! Wie geht es dir? Das ist ein Test deutscher Untertitel mit Umlauten: Käse, Größe, Müller und Straße.
1
00:00:01,000 --> 00:00:03,000
Hallo! Wie geht es dir? Das ist ein Test deutscher Untertitel mit Umlauten: Käse, Größe, Müller und Straße.
Warum die Erkennung falsch liegen kann
Das Werkzeug kann nur die Bytes ansehen. Eine lange Datei mit vielen Umlauten ist leicht zu erkennen. Eine kurze Datei mit ein oder zwei Wörtern mit Umlauten kann zu mehreren Zeichensätzen passen. Deshalb weist die Seite darauf hin, wenn sie unsicher ist, und bittet Sie, die Vorschau zu prüfen. Sprachen mit gemeinsamen Buchstaben, etwa mitteleuropäische Sprachen, brauchen am ehesten eine manuelle Auswahl.
Häufige Fehler
- Eine Datei zweimal konvertieren. Ist die Datei schon UTF-8 und Sie erzwingen einen alten Zeichensatz, erzeugen Sie das ö-Problem selbst. Lassen Sie den erkannten Wert stehen, solange die Vorschau nicht falsch aussieht.
- In einem alten Editor erneut speichern. Manche Texteditoren speichern standardmäßig im Zeichensatz des Systems. Speichern Sie als UTF-8 oder laden Sie die Datei erneut aus dem Werkzeug herunter.
- Die Schrift verantwortlich machen. Zeigt die Vorschau die richtigen Buchstaben, der Fernseher aber Kästchen, hat dessen Schrift die Buchstaben womöglich nicht. Das ist ein Player-Problem, kein Kodierungsproblem.
Sind die Buchstaben richtig, können Sie SDH-Hinweise entfernen oder die Datei in ein anderes Format konvertieren.
Fragen
Welcher Zeichensatz ist für Untertitel am besten?
UTF-8. Er kann alle Sprachen speichern, und aktuelle Player, Fernseher, YouTube und Videoschnittprogramme lesen ihn. Ältere Dateien sind oft in einem regionalen Zeichensatz wie Windows-1252 oder Windows-1251 gespeichert.
Kann ich die Zeichen mit einer Player-Einstellung beheben?
Manchmal. Manche Player lassen Sie die Kodierung der Untertitel wählen, doch die Einstellung hilft nur auf diesem Gerät und für diesen einen Dateityp. Die Originaldatei in UTF-8 zu konvertieren, hilft Playern, die UTF-8 unterstützen. Fehlen Zeichen in der Schriftart, brauchen Sie einen anderen Player oder eine andere Schrift.
In der Datei selbst stehen Fragezeichen. Lassen sich die Buchstaben wiederherstellen?
Nein. Enthält die Datei echte Fragezeichen, gingen die ursprünglichen Buchstaben beim Speichern verloren. Suchen Sie eine andere Kopie der Untertitel.
Was ist ein BOM und brauche ich ihn?
Eine Byte-Reihenfolge-Markierung (BOM) ist eine unsichtbare Markierung am Dateianfang, die UTF-8 anzeigt. Die meisten Player brauchen sie nicht. Aktivieren Sie sie nur, wenn ein älteres Windows-Programm weiterhin falsche Buchstaben zeigt.