Ce que les symptômes veulent dire
Chaque fichier stocke les lettres sous forme de nombres. Un jeu de caractères (encodage) est la table qui indique quel nombre correspond à quelle lettre. Les lettres anglaises simples ont les mêmes nombres dans presque toutes les tables : des sous-titres anglais se cassent donc rarement. Les lettres accentuées, le cyrillique, le grec, l’arabe, l’hébreu, le chinois et le japonais, eux, n’ont pas les mêmes nombres.
| Vous voyez | Ce qu’il faudrait | Ce qui s’est passé |
|---|---|---|
café |
café | Un fichier UTF-8 a été lu comme du Windows-1252 (Europe occidentale) |
Γειά σου |
Γειά σου | Un fichier UTF-8 a été lu comme du Windows-1252 |
Ïðèâåò |
Привет | Un fichier Windows-1251 (cyrillique) a été lu comme du Windows-1252 |
caf� |
café | Un fichier Windows-1252 a été lu comme de l’UTF-8 |
caf? ou ??????? |
café | Le texte a été enregistré par un programme qui ne pouvait pas stocker les lettres ; elles sont perdues |
Deux caractères pour chaque lettre accentuée (é, è) signifient presque toujours qu’un fichier UTF-8 a été lu à l’ancienne. Un losange noir avec un point d’interrogation (�) signale en général l’inverse : un ancien jeu de caractères lu comme de l’UTF-8.
Vérifiez le fichier d’origine avant de convertir. Si les mauvaises lettres ou les caractères de remplacement ont déjà été enregistrés dans le texte, changer de jeu de caractères ne les restaure pas. Utilisez une copie intacte ; un texte déjà enregistré avec des erreurs comme é demande une réparation séparée.
Réparer le fichier : l’enregistrer en UTF-8
- Ouvrez Réparer l’encodage des sous-titres et ajoutez les fichiers de sous-titres.
- L’outil devine le jeu de caractères d’après le texte et indique son degré de confiance, avec les 20 premières lignes.
- Lisez ces lignes. Si les lettres semblent incorrectes, choisissez un autre Jeu de caractères ; l’aperçu se met à jour aussitôt.
- Téléchargez le fichier. Il est enregistré en UTF-8, avec les mêmes lignes, les mêmes horaires et les mêmes retours à la ligne.
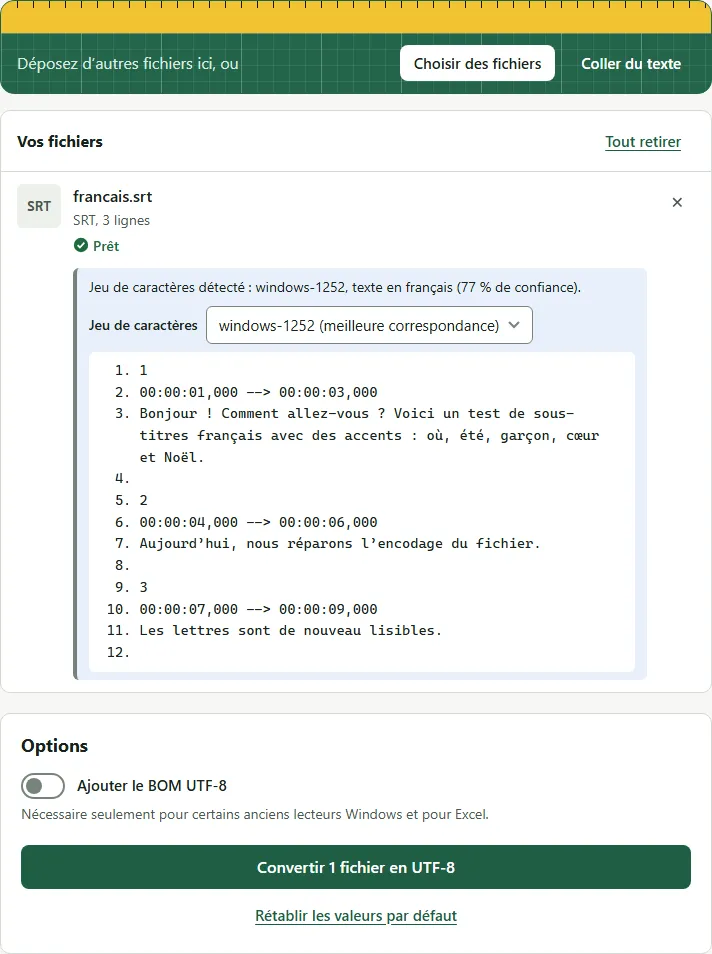
Par exemple, cette ligne française enregistrée en Windows-1252 est détectée et enregistrée en UTF-8 sans changer une seule lettre :
1
00:00:01,000 --> 00:00:03,000
Bonjour ! Comment allez-vous ? Voici un test de sous-titres français avec des accents : où, été, garçon, cœur et Noël.
1
00:00:01,000 --> 00:00:03,000
Bonjour ! Comment allez-vous ? Voici un test de sous-titres français avec des accents : où, été, garçon, cœur et Noël.
Pourquoi la détection peut se tromper
L’outil ne peut regarder que les octets. Un long fichier avec beaucoup de lettres accentuées est facile à détecter. Un fichier court avec un ou deux mots accentués peut correspondre à plusieurs jeux de caractères : la page signale alors son doute et vous demande de vérifier l’aperçu. Les langues qui partagent des lettres, comme les langues d’Europe centrale, sont les plus susceptibles de demander un choix manuel.
Erreurs courantes
- Convertir un fichier deux fois. Si le fichier est déjà en UTF-8 et que vous forcez un ancien jeu de caractères, vous créez vous-même le problème du é. Gardez la valeur détectée, sauf si l’aperçu semble faux.
- Réenregistrer dans un ancien éditeur. Certains éditeurs de texte enregistrent par défaut dans le jeu de caractères du système. Enregistrez en UTF-8, ou retéléchargez le fichier depuis l’outil.
- Accuser la police. Si l’aperçu montre les bonnes lettres mais que le téléviseur affiche des carrés, la police du téléviseur n’a peut-être pas ces lettres. C’est un problème de lecteur, pas d’encodage.
Une fois les lettres correctes, vous pouvez nettoyer les notes pour sourds et malentendants ou convertir le fichier dans un autre format.
Questions fréquentes
Quel est le meilleur encodage pour des sous-titres ?
L’UTF-8. Il peut stocker toutes les langues, et les lecteurs actuels, les téléviseurs, YouTube et les logiciels de montage vidéo le lisent. Les fichiers anciens étaient souvent enregistrés dans un jeu de caractères régional, comme Windows-1252 ou Windows-1251.
Puis-je corriger les caractères en changeant un réglage du lecteur ?
Parfois. Certains lecteurs permettent de choisir l’encodage des sous-titres, mais le réglage ne vaut que sur cet appareil et pour ce type de fichier. Convertir le fichier d’origine en UTF-8 aide les lecteurs qui le prennent en charge ; des caractères absents de la police demandent de changer de lecteur ou de police.
Les lettres sont des points d’interrogation dans le fichier lui-même. Peut-on les récupérer ?
Non. Si le fichier contient de vrais points d’interrogation, les lettres d’origine ont été perdues à l’enregistrement. Cherchez une autre copie des sous-titres.
Qu’est-ce qu’un BOM, et en faut-il un ?
Une marque d’ordre des octets (BOM) est un repère invisible au début d’un fichier, qui indique de l’UTF-8. La plupart des lecteurs n’en ont pas besoin. Activez-la seulement si un ancien programme Windows affiche encore des lettres altérées.